

第 26 篇的寫審實驗裡,「要不要再審一次」是協調者自己決定的。第 2 次跑的時候,它判斷再跑也一樣,就停下來問我 cursor 的參數叫什麼。這個判斷很合理,可是事先沒人知道它會這樣做。
這一篇把同一個寫審環寫成一張明確的圖。模型全程是 Claude,每一步都交給 Claude Code 的 claude -p 去跑,LangGraph 只負責把圖畫出來、存檔、停下來等人。先講結論:圖寫成程式之後,多出來三樣東西:一份每個節點都讀得到的狀態、每走一步就存一次的檢查點,以及一個可以停下來等人的地方。 付出去的是彈性:第 26 篇那種臨場決定,要你事先畫成一條邊。
節點有四個:寫、審、人工核准、存檔。
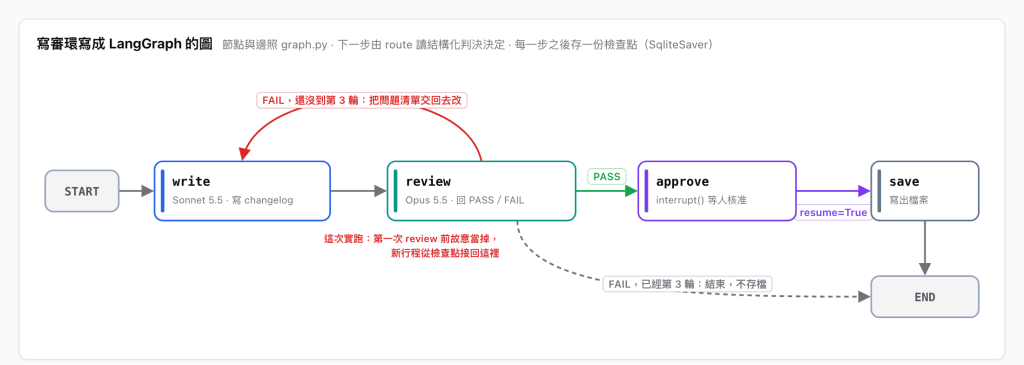
關鍵是 review 後面那條條件邊:
class Verdict(BaseModel):
    verdict: Literal["PASS", "FAIL"]
    issues: list[str]  # 「規則編號:問題」

def route(state: State) -> Literal["approve", "write", "__end__"]:
    if state["verdicts"][-1] == "PASS":
        return "approve"
    return "write" if state["round"] < MAX_ROUNDS else END

g = StateGraph(State)
g.add_node("write", write)
g.add_node("review", review)
g.add_node("approve", approve)
g.add_node("save", save)
g.add_edge(START, "write")
g.add_edge("write", "review")
g.add_conditional_edges("review", route)
g.add_edge("approve", "save")
g.add_edge("save", END)
graph = g.compile(checkpointer=SqliteSaver(sqlite3.connect("checkpoints.sqlite")))
寫的節點呼叫 Claude Sonnet 5.5,審的節點呼叫 Claude Opus 5.5,兩個都走 Claude Code 的非互動模式,用本來的登入,不需要 API key。工具全關(--tools ""),審查加上 --json-schema,判決會放在輸出的 structured_output 欄位。這就是第 26 篇說的「審 → 寫,傳結構化的判決」,route 讀一個欄位就決定下一步。
第 26 篇是協調者模型讀完審查結果,自己決定下一步。這裡是 route 那幾行程式,同樣的輸入,永遠走同一條邊。第 26 篇發現每一輪的審查者都是新的,看不到自己上一輪說過什麼,這張圖沒有解決這件事。差別是上一輪的判決現在就在狀態裡,要不要交給審查者,是我寫不寫進提示詞的事。
把任務寫成狀態和轉移,學界有現成的說法。StateFlow(Wu et al., arXiv 2024)把 LLM 解題的過程看成一台狀態機,每個狀態代表流程目前走到哪,狀態之間的轉移可以由寫死的規則決定,也可以交給 LLM 決定。摘要報告在 InterCode SQL 和 ALFWorld 上,成功率比 ReAct 高 13% 和 28%,成本分別少 5 倍和 3 倍。用它的分法看,route 是規則決定的轉移,第 26 篇的協調者是 LLM 決定的轉移。
LangGraph 官方把 State 定義成一份共用的資料結構,代表應用程式當下的快照。節點拿到目前的狀態,回傳要更新的欄位(2026-10-11 查):
class State(TypedDict):
    commits: str        # git log,含 hash
    rules: str          # 四條規則,只有 review 會放進提示詞
    changelog: str      # write 的產出
    feedback: list[str] # review 給的問題清單
    round: int
    verdicts: list[str]
    status: str         # approve 的結果
規則只有 review 會放進提示詞。第 26 篇第一版的寫手自己去資料夾把 RULES.md 讀了出來,這裡的寫手沒有工具,它看得到的只有 write 送進去的那段字。
第 1 篇說過,messages 這個結構會跟著走完七層,每加一層,要嘛是在陣列裡多塞東西,要嘛是在外面多包一層流程。到第七層是後者。前面幾層的對話越疊越長,這裡每個節點送出去的,都是用 State 當場組出來的一則新請求。誰寫過什麼、審到第幾輪,搬到了請求外面,放在 State 和檢查點裡。
編譯時傳一個 checkpointer,LangGraph 會在每一步之後存一份檢查點(checkpoint),裡面有當下的狀態值、下一步要跑的節點、所屬的執行緒(thread_id)。這裡的檢查點存的是圖的狀態,跟第 15 篇提到 Claude Code 用 /rewind 倒回去的那種檢查點是兩回事。官方的說法是,某一步失敗了,可以從最後一個成功的步驟重新開始(2026-10-11 查)。
我在 review 開頭放了一個開關,第一次審查前故意丟一個例外,然後開一個全新的行程,用同一個 thread_id 呼叫 graph.invoke(None, config)。實際跑一次(2026-10-11,例子,不是證據):
get_state 顯示 next=('review',)、round=1。review 開始,沒有重寫第一版。第一輪 FAIL:分類用了 Features、Bug Fixes、Documentation、Chores,破壞性變更的標題寫成英文的 Breaking Changes,前面還加了一個警告符號,hash 用了半形括號。approve。True,跑完 save,寫出 changelog.md。整趟四次模型呼叫,寫手兩次、審查兩次,當機沒有造成任何一次重複。0.08 美元,約 26 秒。get_state_history 從頭到尾 8 份檢查點,next 依序是 __start__、write、review、write、review、approve、save、空。
這次的審查讓只有 commit 原句的破壞性變更通過了,第 26 篇第 2 次判同一句違反規則 2。換一次呼叫,判決就可能不一樣,這張圖沒有改變這件事。另外,token-inspectour 攔到的四則請求都在 2.7K 到 3.6K 詞元之間,工具全關也一樣,因為 Claude Code 自己的系統提示會一起送出去。改成直接打 API,只要換掉呼叫模型的兩個函式。
第 13 篇說記憶不在 Claude 那裡,存在哪是你的事。檢查點就是那句話在圖上的版本。存的時機官方給了三種:exit 跑完才存,async 邊跑邊存,sync 每一步存完才往下走,越後面越穩也越慢。
審查通過之後,approve 呼叫 interrupt(),圖就停在這裡:
def approve(state: State):
    ok = interrupt({"question": "審查通過,要存檔嗎?", "changelog": state["changelog"]})
    return {"status": "approved" if ok else "rejected"}
interrupt() 會用檢查點把狀態存起來,等外面的輸入。人看完之後,用 graph.invoke(Command(resume=True), config) 接回去,True 就是 interrupt() 的回傳值,所以人可以隔一天再回來按。接回的時候,被中斷的那個節點會從頭重跑(2026-10-11 查)。如果你在 interrupt() 之前寄了一封信,接回時就會再寄一次。這是分散式系統的老問題。Elnozahy 等人(ACM Computing Surveys, 2002)整理回溯復原(rollback-recovery)時,把系統外面那些收不回來的輸入輸出叫做「外部世界」,外部世界不能指望它跟著回溯,所以只靠檢查點的復原,不適合常跟外部世界互動的程式。寄信、扣款、呼叫外部 API 都是外部世界,放在會重跑的節點裡,就要寫成重跑也不會出事。
第 26 篇的協調者是自己決定停下來問人的,這裡停在哪、問什麼,是我畫在圖上的。什麼時候該問人,人機互動領域早就討論過。Horvitz(CHI 1999)的混合主導(mixed-initiative)介面原則裡,有一條是系統對使用者的意圖不確定時,用對話把關鍵的不確定釐清,同時要考慮白白打擾使用者的成本。第 26 篇的協調者是碰到規則打架、缺了資料才停下來問,比較接近這條。這張圖則是每次審查通過都問,不管有沒有不確定。這也跟第 20 篇的權限系統是兩回事:權限擋的是一次工具呼叫,interrupt() 停的是流程裡的一步。
狀態、檢查點、等人插手,是圖工程本身的需求,Claude 自己的工具也各有一套做法(2026-10-11 查):
| 需求 | LangGraph | Claude Agent SDK/Claude Code | Managed Agents |
|---|---|---|---|
| 存什麼 | 你定義的 State,每一步一份檢查點 |
工作階段(session):整段對話,存成 ~/.claude/projects/ 底下的 .jsonl,不含檔案變更 |
每個代理的執行緒會留著,可以追問 |
| 怎麼接回 | 同一個 thread_id,invoke(None, config) |
resume 傳 session ID,或 continue 接最近一個 |
對同一條執行緒再送一則訊息 |
| 人從哪裡插手 | 任何節點裡都能 interrupt() |
工具呼叫要權限時走 canUseTool 回呼 |
子代理要權限時,事件轉到主執行緒 |
| 下一步誰決定 | 你寫的邊 | 模型,在迴圈裡 | 協調者模型 |
Claude 那邊存的是對話,接回之後模型看到完整的歷史,自己接著想。LangGraph 存的是你定義的欄位,接回之後從下一個節點開始跑。
人工核准的部分我也跑了一次。用 Agent SDK 叫 Claude 把同樣那五則 commit 整理成 changelog.md,寫檔要經過回呼:
async def can_use_tool(tool_name, input_data, context):
    if tool_name == "Write" and first_write():  # 第一次寫檔
        return PermissionResultDeny(
            message="先不要存。這份是要給客戶看的,chore 和 docs 那兩條拿掉,其他照舊,改好再存。")
    return PermissionResultAllow(updated_input=input_data)
Claude 第一次要寫的檔案有五節,最後兩節是「文件(Documentation)」和「維護(Chores)」。回呼擋下來,那段話交給 Claude,它第二次要寫的內容只少了那兩節,這次放行(2026-10-11,Claude Opus 5.5,0.11 美元)。讀檔和唯讀的 git 指令會在更前面自動放行,不經過回呼。Python 版照官方文件還要用串流送提示詞、掛一個空的 PreToolUse hook。這裡回答的是一段程式,換成真的人,就是回呼裡等他按同意或打一段話。
兩種插手的差別:回呼是 Claude 來問,單位是一次工具呼叫,人的回答變成 Claude 看到的一段話。interrupt() 是圖停在你指定的節點,人的回答變成 State 裡的一個值,下一步由你寫的邊決定。
第一,彈性換成了可控。 第 26 篇的協調者看出規則打架,自己停下來問人。這張圖只會照 route 走到第三輪結束。想要它停下來問,得先把「什麼情況要問」寫成一條邊。
第二,存檔要時間和空間。 sync 模式下每一步都要等存完,SQLite 檔案會一直長,舊的執行緒要自己清。
第三,接回時會重跑。 被中斷或沒跑完的節點會從頭來過,有副作用的節點要寫成重跑也不會出事。
多了什麼能力:會用 LangGraph 把寫審環寫成明確的圖,用共用的
State傳東西、用條件邊決定下一步、用檢查點在當機後接回、用interrupt()留一個等人的位置,並且分得清它跟 Claude Agent SDK 的工作階段、canUseTool、Managed Agents 的執行緒各存什麼、在哪裡讓人插手。多付了什麼代價:沒畫在圖上的情況它不會應變、每一步存檔的時間與空間,以及接回時重跑的那一步。
拆成好幾個代理、接成一張圖之後,第 4 篇那 10 題會變好嗎?帳單又多了多少?
官方文件
State、節點、條件邊。interrupt() 與 Command(resume=...)。canUseTool 回呼。論文


把審查結果的 verdict 用 Literal 限死、再用條件邊接 retry,這比讓協調者臨場判斷好驗證。我會多測一個情況:審查節點一直回 FAIL 時,有沒有最大重試次數,還有從檢查點接回時 state 裡的 issues 會不會重複累加。可以故意讓 review 固定回 FAIL,跑到中途殺掉行程再接回,看節點次數和 issues 長度是否符合預期。

 iThome鐵人賽
 看影片追技術